문제링크
https://school.programmers.co.kr/learn/courses/30/lessons/42890
프로그래머스
SW개발자를 위한 평가, 교육의 Total Solution을 제공하는 개발자 성장을 위한 베이스캠프
programmers.co.kr
문제 핵심
- 관계 데이터베이스에서 릴레이션(Relation)의 튜플(Tuple)을 유일하게 식별할 수 있는 속성(Attribute) 또는 속성의 집합 중, 다음 두 성질을 만족하는 것을 후보 키(Candidate Key)라고 한다.
- 유일성(uniqueness) : 릴레이션에 있는 모든 튜플에 대해 유일하게 식별되어야 한다.
- 최소성(minimality) : 유일성을 가진 키를 구성하는 속성(Attribute) 중 하나라도 제외하는 경우 유일성이 깨지는 것을 의미한다. 즉, 릴레이션의 모든 튜플을 유일하게 식별하는 데 꼭 필요한 속성들로만 구성되어야 한다.
문제 풀이법
-배열의 모든조합키 만들기
문제에서 제시한
유일성 검사하기
최소성 검사하기
코드
public static int solution(String[][] relation) {
int answer = 0;
Map<String, List<String>> map = new LinkedHashMap<>();
for (int i = 0; i < relation.length; i++) {
boolean[] visited = new boolean[relation[0].length];
for (int ii = 0; ii < relation[0].length; ii++) {
System.out.println(relation[i][ii] + "," + ii + "");
List<String> list = new LinkedList<>();
if (map.containsKey(ii + "")) {
list = map.get(ii + "");
}
list.add(relation[i][ii]);
map.put(ii + "", list);
visited[ii] = true;
dfs(visited, relation[i], relation[i][ii], ii + 1, ii + "", map);
visited[ii] = false;
}
}
System.out.println("map: " + map);
List<String> list = new ArrayList<>();
for (Map.Entry<String, List<String>> entry : map.entrySet()) {
String key = entry.getKey();
List<String> value = entry.getValue();
if (new HashSet<>(value).size() != value.size()) {
System.out.println(key + "중복 있음");
} else {
System.out.println(key + "중복 없음");
list.add(key);
}
}
System.out.println(list);
for (int i = 0; i < list.size(); i++) {
boolean flag = true;
for (int ii = 0; ii < list.size(); ii++) {
if (i == ii) {
continue;
}
String fk = list.get(i);
String sk = list.get(ii);
Set<Character> fkSet = fk.chars()
.mapToObj(c -> (char) c)
.collect(Collectors.toSet());
Set<Character> skSet = sk.chars()
.mapToObj(c -> (char) c)
.collect(Collectors.toSet());
System.out.println("fkSet: " + fkSet);
System.out.println("skSet: " + skSet);
if (skSet.containsAll(fkSet) || fkSet.containsAll(skSet)) {
if (fkSet.size() > skSet.size()) {
System.out.println("fk가 sk의 부분집합");
flag = false;
break;
}
}
}
if (flag) {
System.out.println("포함안됨");
answer += 1;
}
}
System.out.println(answer);
return answer;
}
public static void dfs(boolean[] visited, String[] relation, String sout, int start, String key,
Map<String, List<String>> map) {
for (int ii = start; ii < relation.length; ii++) {
if (!visited[ii]) {
visited[ii] = true;
System.out.println(sout + relation[ii] + "," + key + ii);
List<String> list = new LinkedList<>();
if (map.containsKey(key + ii)) {
list = map.get(key + ii);
}
list.add(sout + relation[ii]);
map.put(key + ii, list);
// System.out.println("자식 시작: " + ii);
dfs(visited, relation, sout + relation[ii], ii + 1, key + ii, map);
visited[ii] = false;
// System.out.println("백트래킹: " + ii + Arrays.toString(visited));
}
}
}
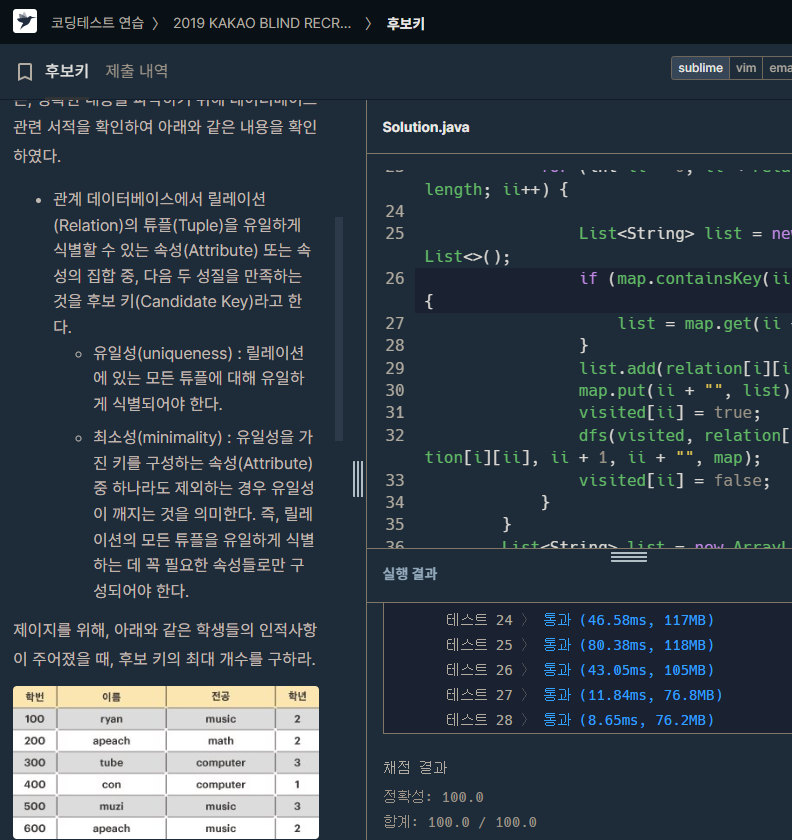
결과
gpt피드백
-핵심 개선점만 요약하면:
- DFS를 행마다 돌리지 않기
- 현재: 각 행마다 같은 컬럼 조합을 반복 생성
- 개선: 컬럼 조합은 DFS로 한 번만 생성 → 그 조합으로 모든 행 검사
- visited 생략 가능
- 조합 DFS는 start = ii + 1 때문에 뒤로 못 가므로 중복 선택이 이미 방지됨.
- Map<String, List<String>>에 결과 전부 저장할 필요 없음
- 조합 하나마다 바로 HashSet으로 행 값을 검사.
- set.size() == relation.length면 유일성 O.
- 최소성 검사를 단방향으로 단순화
- 현재 후보가 이미 확정된 작은 후보키를 포함하는지만 확인하면 됨.
- 양쪽 containsAll()을 모두 볼 필요 없음.
배운점과느낀점
-졸라 어려웠다 이문제는 생각은 금방끝났는데
생각을 코드로 짜는데 어려웠다
그래도 포기 하지 않고 풀었다는게 좋다.
Set<Character> fkSet = fk.chars()
.mapToObj(c -> (char) c)
.collect(Collectors.toSet());
Set<Character> skSet = sk.chars()
.mapToObj(c -> (char) c)
.collect(Collectors.toSet());
System.out.println("fkSet: " + fkSet);
System.out.println("skSet: " + skSet);
if (skSet.containsAll(fkSet) || fkSet.containsAll(skSet)) {
if (fkSet.size() > skSet.size()) {
System.out.println("fk가 sk의 부분집합");
flag = false;
break;
}
}
이부분집합부분에서 또 애를 먹긴했는데
어쨋든 좋은 프리셋이 있어서 금방 구했다
'코테 > lvl2' 카테고리의 다른 글
| 프로그래머스 거리두기 확인하기(lvl2) 풀어보기 (0) | 2026.09.15 |
|---|---|
| 프로그래머스 메뉴 리뉴얼(lvl2) 풀어보기 (0) | 2026.09.15 |
| dfs 조합이해하기 (0) | 2026.09.14 |
| 프로그래머스 오픈채팅방(lvl2) 풀어보기 (0) | 2026.09.14 |
| 프로그래머스 캐시(lvl2) 풀어보기 (0) | 2026.09.14 |